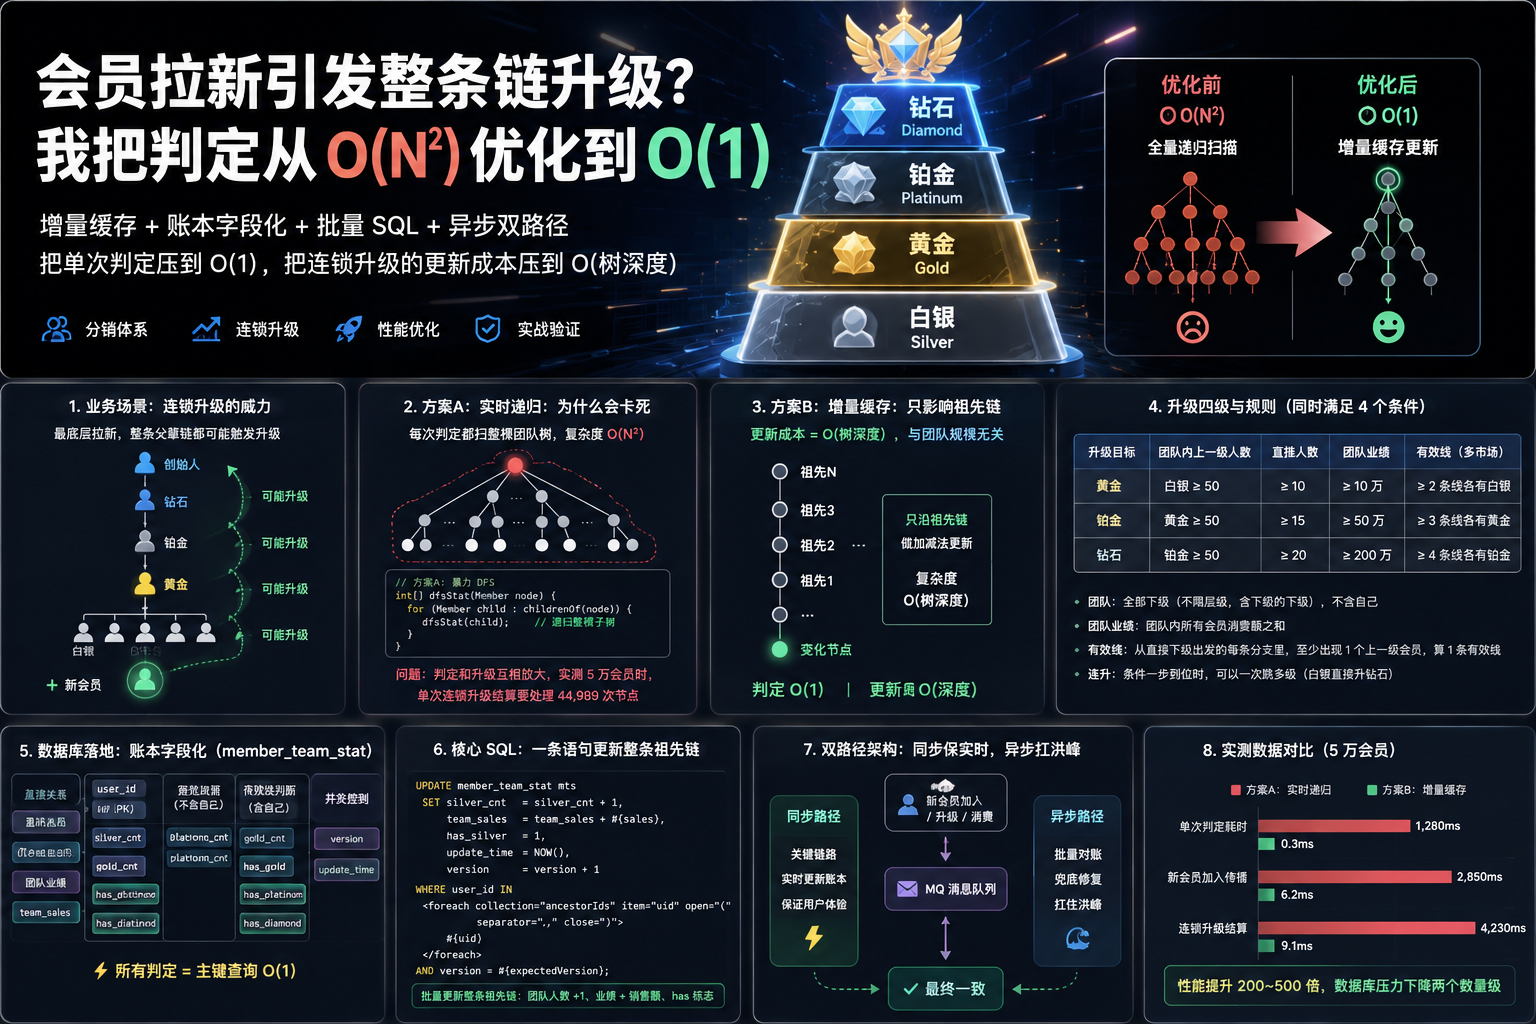
摘要 :做分销 / 会员体系的朋友都懂这个噩梦——最底下的会员拉了一个新人,结果整条父辈链上每个人都可能触发升级;而每次升级判定都要把整个团队重新扫一遍,人一多直接卡死。本文分享一套经过实战验证的解法:增量缓存 + 账本字段化 + 批量 SQL + 异步双路径 ,把单次判定压到 O(1),把连锁升级的更新成本压到 O(树深度),并附完整 Java 实现与实测数据。
目录
业务场景与升级规则 方案A:为什么实时递归会卡死 核心洞察:增量缓存(方案B) 数据库落地:账本字段化 一条 SQL 批量更新整条祖先链 连锁升级:为什么必须从下往上 大厂双路径:同步保实时,异步扛洪峰 实测数据对比 总结与心得
1. 业务场景与升级规则 假设你在做一个会员分销系统:会员分白银 → 黄金 → 铂金 → 钻石 四级,升下一级需要同时满足 4 个条件 :
升级目标
团队内上一级人数
直推人数
团队业绩
有效线(多市场)
黄金
白银 ≥ 50
≥ 10
≥ 10 万
≥ 2 条线各有白银
铂金
黄金 ≥ 50
≥ 15
≥ 50 万
≥ 3 条线各有黄金
钻石
铂金 ≥ 50
≥ 20
≥ 200 万
≥ 4 条线各有铂金
几个容易踩坑的术语口径:
团队 = 全部下级(不限层级,含下级的下级),不含自己 团队业绩 = 团队内所有会员消费额之和有效线 = 从直接下级出发的每条分支里,至少出现 1 个上一级会员,算 1 条有效线连升 = 条件一步到位时,可以一次跳多级(白银直接升钻石)
看似简单,但这个体系有一个致命场景 :
最底层的会员拉了一个新会员 → 他的所有父辈的”团队人数 / 业绩”都变了 → 整条父辈链上每个人都可能触发升级 → 而每次升级又会改变更高层的账本……连锁反应一路烧到创始人。
规模一大,这个连锁反应就会把系统拖垮。
2. 方案A:为什么实时递归会卡死 最直观的做法:每次判定时,把该会员的整棵下级树重新遍历一遍 统计:
1 2 3 4 5 6 7 int [] dfsStat(Member node, int level) { for (Member child : childrenOf(node)) { dfsStat(child, level); } }
问题在于判定和升级会互相放大 :
判定一个会员 = 扫他的整个团队,复杂度 O(团队规模)
全平台判一遍 = O(N²)
更糟的是升级连锁 :底层升级 → 影响所有祖先 → 每个祖先又要各自全量重扫一遍团队
实测 5 万会员时,单次”连锁升级结算”要处理 44,989 次节点 ——数据库早在几千人的时候就开始卡了。
3. 核心洞察:增量缓存(方案B) 先想清楚一个事实:**每个节点的数据变化,只影响”包含它的祖先”**。
1
2
3
4
5
6
7
一个节点的账本只汇总"自己的子树" ↓ 某节点变化,只影响"包含它的祖先"的账本 ↓ 这些祖先恰好是 parent 链上那一串(兄弟 / 后代 / 无关节点不受影响) ↓ 所以更新成本 = O(树深度),与团队规模无关
于是思路反转:不现算,改缓存 。给每个会员维护一份”团队账本”——团队里各等级人数、团队业绩、子树里有没有某等级会员。数据变化时,只沿祖先链做加减法 :
操作
方案A(实时递归)
方案B(增量缓存)
单会员判定
O(团队规模) ≈ O(N)
O(1)
新会员加入传播
O(N·深度)
O(深度)
单人升级传播
O(N·深度)
O(深度)
这就是方案B 的全部秘密:**判定 O(1),更新 O(深度)**,没有更低的下限。
4. 数据库落地:账本字段化 方案B 的数据库形态:一张 member_team_stat 账本表,一人一行,字段就是”缓存”:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
CREATE TABLE `member_team_stat` ( `user_id` BIGINT UNSIGNED NOT NULL COMMENT '会员ID(主键)' , `parent_id` BIGINT UNSIGNED NOT NULL DEFAULT 0 COMMENT '直接上级ID(有效线判断用)' , `direct_cnt` INT NOT NULL DEFAULT 0 COMMENT '直推人数' , `silver_cnt` INT NOT NULL DEFAULT 0 COMMENT '团队内白银数(不含自己)' , `gold_cnt` INT NOT NULL DEFAULT 0 COMMENT '团队内黄金数(不含自己)' , `platinum_cnt` INT NOT NULL DEFAULT 0 COMMENT '团队内铂金数(不含自己)' , `diamond_cnt` INT NOT NULL DEFAULT 0 COMMENT '团队内钻石数(不含自己)' , `team_sales` DECIMAL (14 ,2 ) NOT NULL DEFAULT 0 COMMENT '团队业绩(不含自己)' , `has_silver` TINYINT NOT NULL DEFAULT 0 COMMENT '子树(含自己)是否存在白银会员,有效线判断用' , `has_gold` TINYINT NOT NULL DEFAULT 0 COMMENT '子树(含自己)是否存在黄金会员' , `has_platinum` TINYINT NOT NULL DEFAULT 0 COMMENT '子树(含自己)是否存在铂金会员' , `has_diamond` TINYINT NOT NULL DEFAULT 0 COMMENT '子树(含自己)是否存在钻石会员' , `version` INT NOT NULL DEFAULT 0 COMMENT '乐观锁版本号,防止并发覆盖' , `update_time` DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP COMMENT '最后更新时间' , PRIMARY KEY (`user_id`), KEY `idx_parent` (`parent_id`) ) ENGINE= InnoDB DEFAULT CHARSET= utf8mb4 COMMENT= '会员团队统计账本表(增量缓存的数据库形态)' ;
几个字段的设计意图,值得多说两句:
*_cnt 不含自己has_* 含自己COUNT(*) WHERE parent_id = ? AND has_silver = 1,一笔覆盖整条分支,不用递归version 乐观锁user_id 为主键
会员表这边,多加一个”作弊”字段:
1
2
3
4
5
6
7
8
9
10
11
CREATE TABLE `member ` ( `id` BIGINT UNSIGNED NOT NULL AUTO_INCREMENT COMMENT '会员ID' , `name` VARCHAR (50 ) NOT NULL COMMENT '姓名' , `level` TINYINT NOT NULL DEFAULT 0 COMMENT '等级:0白银 1黄金 2铂金 3钻石' , `sales` DECIMAL (14 ,2 ) NOT NULL DEFAULT 0 COMMENT '个人累计消费额(元)' , `parent_id` BIGINT UNSIGNED NOT NULL DEFAULT 0 COMMENT '直接上级ID,0=平台创始人' , `ancestor_ids` VARCHAR (1024 ) NOT NULL DEFAULT '' COMMENT '全部祖先ID链,逗号分隔(冗余,插入时继承父亲),用于批量UPDATE整条链' , `create_time` DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '注册时间' , PRIMARY KEY (`id`), KEY `idx_parent` (`parent_id`) ) ENGINE= InnoDB DEFAULT CHARSET= utf8mb4 COMMENT= '会员表' ;
ancestor_ids 是空间换时间的经典手笔WHERE user_id IN (...) 的批量 SQL,再也不用递归查树 。
补充一句:如果你有大量”会员换上级/移巢”操作,就该考虑闭包表了;会员体系这种”树只增不减”的场景,冗余祖先链是最简单的正解。
5. 一条 SQL 批量更新整条祖先链 核心动作来了。新会员加入 时,沿祖先链批量更新(一条 SQL 同时处理:团队人数 +1、业绩 + 销售额、has 标志):
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
@Update("<script>" + "UPDATE member_team_stat SET " + " silver_cnt = silver_cnt + (CASE WHEN #{level}=0 THEN 1 ELSE 0 END), " + " gold_cnt = gold_cnt + (CASE WHEN #{level}=1 THEN 1 ELSE 0 END), " + " platinum_cnt = platinum_cnt + (CASE WHEN #{level}=2 THEN 1 ELSE 0 END), " + " diamond_cnt = diamond_cnt + (CASE WHEN #{level}=3 THEN 1 ELSE 0 END), " + " team_sales = team_sales + #{sales}, " + " has_silver = CASE WHEN #{level}=0 OR silver_cnt > 0 THEN 1 ELSE 0 END, " + " has_gold = CASE WHEN #{level}=1 OR gold_cnt > 0 THEN 1 ELSE 0 END, " + " has_platinum = CASE WHEN #{level}=2 OR platinum_cnt > 0 THEN 1 ELSE 0 END, " + " has_diamond = CASE WHEN #{level}=3 OR diamond_cnt > 0 THEN 1 ELSE 0 END, " + " version = version + 1 " + "WHERE user_id IN " + "<foreach collection='ids' item='id' open='(' separator=',' close=')'>#{id}</foreach>" + "</script>") int batchAddMember (@Param("ids") List<Long> ids, @Param("level") int level, @Param("sales") java.math.BigDecimal sales) ;
会员升级 时同理:整条链上”旧等级 -1、新等级 +1”,一条 SQL 完成:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
@Update("<script>" + "UPDATE member_team_stat SET " + " silver_cnt = silver_cnt + (CASE WHEN #{newLevel}=0 THEN 1 WHEN #{oldLevel}=0 THEN -1 ELSE 0 END), " + " gold_cnt = gold_cnt + (CASE WHEN #{newLevel}=1 THEN 1 WHEN #{oldLevel}=1 THEN -1 ELSE 0 END), " + " platinum_cnt = platinum_cnt + (CASE WHEN #{newLevel}=2 THEN 1 WHEN #{oldLevel}=2 THEN -1 ELSE 0 END), " + " diamond_cnt = diamond_cnt + (CASE WHEN #{newLevel}=3 THEN 1 WHEN #{oldLevel}=3 THEN -1 ELSE 0 END), " + " has_silver = CASE WHEN silver_cnt > 0 THEN 1 ELSE 0 END, " + " has_gold = CASE WHEN gold_cnt > 0 THEN 1 ELSE 0 END, " + " has_platinum = CASE WHEN platinum_cnt > 0 THEN 1 ELSE 0 END, " + " has_diamond = CASE WHEN diamond_cnt > 0 THEN 1 ELSE 0 END, " + " version = version + 1 " + "WHERE user_id IN " + "<foreach collection='ids' item='id' open='(' separator=',' close=')'>#{id}</foreach>" + "</script>") int batchUpgradeCounts (@Param("ids") List<Long> ids, @Param("oldLevel") int oldLevel, @Param("newLevel") int newLevel) ;
升级判定 (O(1) 主键查询 + 四条件比较):
1
2
3
4
5
6
7
8
9
10
public CheckResult checkUpgrade (Long userId, int nextLevel) { Rule r = rules.getLevels().get(nextLevel - 1 ); TeamStat t = teamStatMapper.selectByUserId(userId); boolean cntOk = cntOf(t, r.getNeedLevel()) >= r.getNeedCount(); boolean directOk = t.getDirectCnt() >= r.getNeedDirect(); boolean salesOk = t.getTeamSales().longValue() >= r.getNeedSales(); boolean linesOk = countValidLines(t, r.getNeedLevel()) >= r.getNeedLines(); return new CheckResult (cntOk, directOk, salesOk, linesOk); }
从”递归扫树”变成”查一行 + 比较”,这就是量变到质变。
6. 连锁升级:为什么必须从下往上 回到开头的致命场景:最底层会员拉了一个新人,整条父辈链连锁升级 。流程是这样的:
  sequenceDiagram
    participant App as 业务代码
    participant DB as MySQL
    App->>DB: ① INSERT 新会员X(挂在最底层N名下)
    App->>DB: ② 批量UPDATE账本 IN(N,P1,P2,...root):人数+1、业绩+X销售额
    loop 沿祖先链从下往上:N → P1 → P2 → root
        App->>DB: ③ checkUpgrade(cur):1条主键SQL判定四条件
        alt 达标且未满级
            App->>DB: ④ 升级:等级+1 + 批量UPDATE其父链(旧-1新+1)
            Note over App,DB: 连升:同一人再判最多2次(钻石封顶)
        end
    end
关键问题:为什么必须”从下往上”?
因为底层升级会二次污染上层账本 :N 从白银变黄金后,P1 的”团队黄金数”立刻 +1,P1 可能因此才达标。如果从上往下,P1 判定时 N 还没升级,用的是旧账本 → 漏判 。只有从下往上,每一级都基于最新账本判定,才保证正确。
核心代码其实很短(无任何递归树遍历):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 @Transactional public List<UpgradeStep> runChain (Long newMemberId, String bizId) { List<UpgradeStep> steps = new ArrayList <>(); Member child = memberMapper.selectById(newMemberId); Member cur = child.getParentId() == 0 ? null : memberMapper.selectById(child.getParentId()); while (cur != null ) { while (cur.getLevel() < 3 ) { CheckResult r = teamStatService.checkUpgrade(cur.getId(), cur.getLevel() + 1 ); if (!r.passed()) break ; int from = cur.getLevel(), to = from + 1 ; teamStatService.upgradeMember(cur, to, bizId + "-" + cur.getId()); steps.add(new UpgradeStep (cur.getId(), cur.getName(), from, to)); cur.setLevel(to); } cur = cur.getParentId() == 0 ? null : memberMapper.selectById(cur.getParentId()); } return steps; }
成本核算 :深度 10 层、全员连升 ≈ 40 条以内主键级 SQL,毫秒级完成。对比方案A 的”每层全量重扫团队”,是数量级的差距。
彩蛋:连升逻辑(内层 while)能跑起来的前提是——第 ② 步批量 UPDATE 已经把”团队人数/业绩”一步到位了,所以 N 可能同时满足”升黄金”和”升铂金”,一次处理完。
7. 大厂双路径:同步保实时,异步扛洪峰 单机性能解决后,还有最后一关:升级潮 。活动日每秒几万次”拉新 + 连锁结算”,直接同步打库照样会爆。大厂的做法是双路径 :
  flowchart TB
    subgraph 业务层
        A1[新会员加入] --> B1
        A2[下单/消费] --> B1
        A3[单人查询/单人升级] --> C1
    end
    subgraph 事件层
        B1[(MQ 消息队列)]
    end
    subgraph 结算层
        C1[同步快路径<br>O1读账本 / 批量UPDATE]
        C2[异步批量结算器<br>合并变更]
        C3[定时对账补偿<br>幂等收敛]
    end
    B1 --> C2
    C1 --> D2
    C2 --> D2
    C3 --> D2
    subgraph 数据层
        D2[(账本表 + 流水表)]
    end
同步快路径 :用户查进度、单人升级必须实时,直接读账本表 O(1)。
异步批量路径 :新会员加入等变更先发 MQ,消费者按时间窗合并 同类事件后再批量结算:
1
2
3
4
5
6
7
8
9
10
@RabbitListener(queues = "upgrade.settle.queue", concurrency = "4") public void onEvents (List<MemberChangeEvent> events) { Map<Long, List<MemberChangeEvent>> byParent = groupByParent(events); for (var entry : byParent.entrySet()) { } }
收益 :写放大从 O(事件数) 降到 O(组数),MQ 天然削峰。
最终一致的三件套 ,缺一不可:
环节
做法
不丢
发送方 Confirm + 失败重试/落本地表补发
不重
upgrade_log.biz_id 唯一键 + INSERT IGNORE 幂等
不漏
定时对账:扫出变更用户,临时重算子树实际值,差异批量修正
乐观锁顺带提一句:账本表带 version,UPDATE ... WHERE version = ? 影响行数为 0 就重试(最多 3 次退避),配合”同一用户哈希到同一 MQ 分区串行消费”,冲突概率极低。
8. 实测数据对比 用同一棵随机树,方案A(暴力递归)vs 方案B(增量缓存)对拍,并做双算法互证(全员所有等级逐人比对,结果完全一致):
数据规模
方案A 全员判定
方案B 全员判定
差距
200 人
0.11 ms
0.047 ms
~2.3×
50,000 人
14.24 ms
3.2 ms
~4.5×
再看最要命的连锁升级 (底层拉新引发整条链升级):
方案
单次连锁结算处理的节点数
方案A(每个祖先全量重扫团队)
44,989 次
方案B(只沿祖先链加减法)
13 次
差距 3,461 倍 ——这就是”全量重算”和”增量更新”的本质区别。
如果换成真实 MySQL 场景,差距还会进一步放大:方案A 每扫一层团队就是一次大范围查询,方案B 从头到尾就是”1 条批量 UPDATE + 深度次主键判定”,网络往返从 O(N) 压到 O(深度)。
9. 总结与心得 回顾整条优化链路:
1
2
3
4
5
6
7
方案A 实时递归(O(N²),卡顿) ↓ 核心洞察:变化只影响祖先链 方案B 增量缓存(判定 O(1),更新 O(深度)) ↓ 落库:账本字段化 + 冗余祖先链 一条 SQL 批量更新整条链 ↓ 应对升级潮 双路径:同步保实时 + 异步批量 + 最终一致
几点心得,也是踩坑总结:
先想清楚”影响面”,再谈优化 。很多人一上来就加缓存、上分库分表,其实这个场景的根因是”影响面 = 祖先链”这个事实没有被利用。复杂度下限要心里有数 :判定 O(1)、更新 O(深度) 已经是理论上限,再往后拼的是工程(并发、可靠性、扩展性)。所有优化都是权衡 :账本表是用存储换时间,异步路径是用实时性换吞吐——明确说出换来了什么、代价是什么、怎么兜底,比背一个”完美方案”重要得多。双算法对拍是好习惯 :新算法上线前用暴力算法做基准对拍,全员逐人比对一致,比写 100 条单测都让人放心。
如果对你有帮助,欢迎点赞收藏;对某个环节(比如对账的具体实现、分库分表方案)有疑问,评论区聊聊~
本文同步发布在个人博客。配套可视化演示页面(含 14 条自检用例)与完整工程代码,欢迎在评论区留言索取。